Stage 1 — LLM 基礎(LLM Basics)
LLM(Large Language Model):能讀寫語言的模型。
本章目的:先看懂模型怎麼從資料走到 Agent,再用一條可重複的本機到雲端路徑呼叫 LLM。你會讀懂 Token(詞元)、Context Window(上下文視窗) 與 Temperature(溫度),也會用成本與延遲解釋模型選擇。
📌 學習目標
完成本階段後,你可以:
- 用 Ollama 的本機模型完成第一次 API(Application Programming Interface,讓程式呼叫服務的介面) 呼叫,再用 Anthropic API 做對照。
- 說出模型從 Pre-training、Post-training 到 Inference 的順序。
- 以簡單例子說明 token、context window 與 temperature。
- 從回應的 usage 欄位讀出輸入與輸出 token。
- 用輸入/輸出單價、延遲與資料敏感度解釋模型選擇。
三個核心詞
1. Token(詞元)
Token 是模型讀寫文字時使用的計算單位,也常是 API 計價單位。可以把它想成句子被切成的一小塊積木;一個英文單字可能是一塊,也可能被切成幾塊,中文一個字也不保證只是一塊。本章會在練習 2 讀取實際 input/output token,再用它估算成本;數量要看 tokenizer,不能用字數精確猜測。
2. Context Window(上下文視窗)
Context Window 是模型處理一次請求時可用的 token 空間。它像桌面:你的 prompt 和歷史對話先占位子,模型還要留位子寫答案;型號也可能另設較小的最大輸出上限,所以兩個數字都要查。本章會用它判斷長文件何時要刪減、摘要或分批。
3. Temperature(溫度)
Temperature 是控制抽樣變化程度的參數。把模型想成每次都從幾塊候選積木中挑下一塊:低值偏向最可能的候選,適合分類或固定格式;高值更常嘗試其他候選,適合構思但可能更不穩定。本章把它當成輸出穩定度的旋鈕;它不會增加模型知識,也不會保證完全可重現。
模型怎麼從資料走到 Agent?
先記住一條主線:
資料 → Pre-training → Base Model → Post-training → Instruct Model → Inference → Agent 系統
- Pre-training(預訓練):模型先從大量資料學習文字、圖片或程式碼裡的模式。這一步會改變模型權重。
- Post-training(後訓練):再教模型怎麼照指令、比較偏好,並更安全地完成任務。這一步也會改變權重。常見方法如下。
- SFT(Supervised Fine-Tuning):用好輸入和好答案教模型模仿。
- DPO(Direct Preference Optimization):用較好、較差的答案配對教模型學偏好。
- RLHF(Reinforcement Learning from Human Feedback):把人類回饋用於強化學習。
- RL(Reinforcement Learning):讓模型依獎勵學習;獎勵也可以來自規則。
- Fine-tuning(微調):拿較小、較專門的資料繼續調整模型權重。Post-training 是廣義的後續訓練階段;Fine-tuning 是其中常見的一類做法。
- Inference(推論):訓練完成後,模型收到這次輸入並產生這次結果。這是在使用模型,不是在重新訓練它。
RAG(Retrieval-Augmented Generation):先找相關資料,再依資料回答。
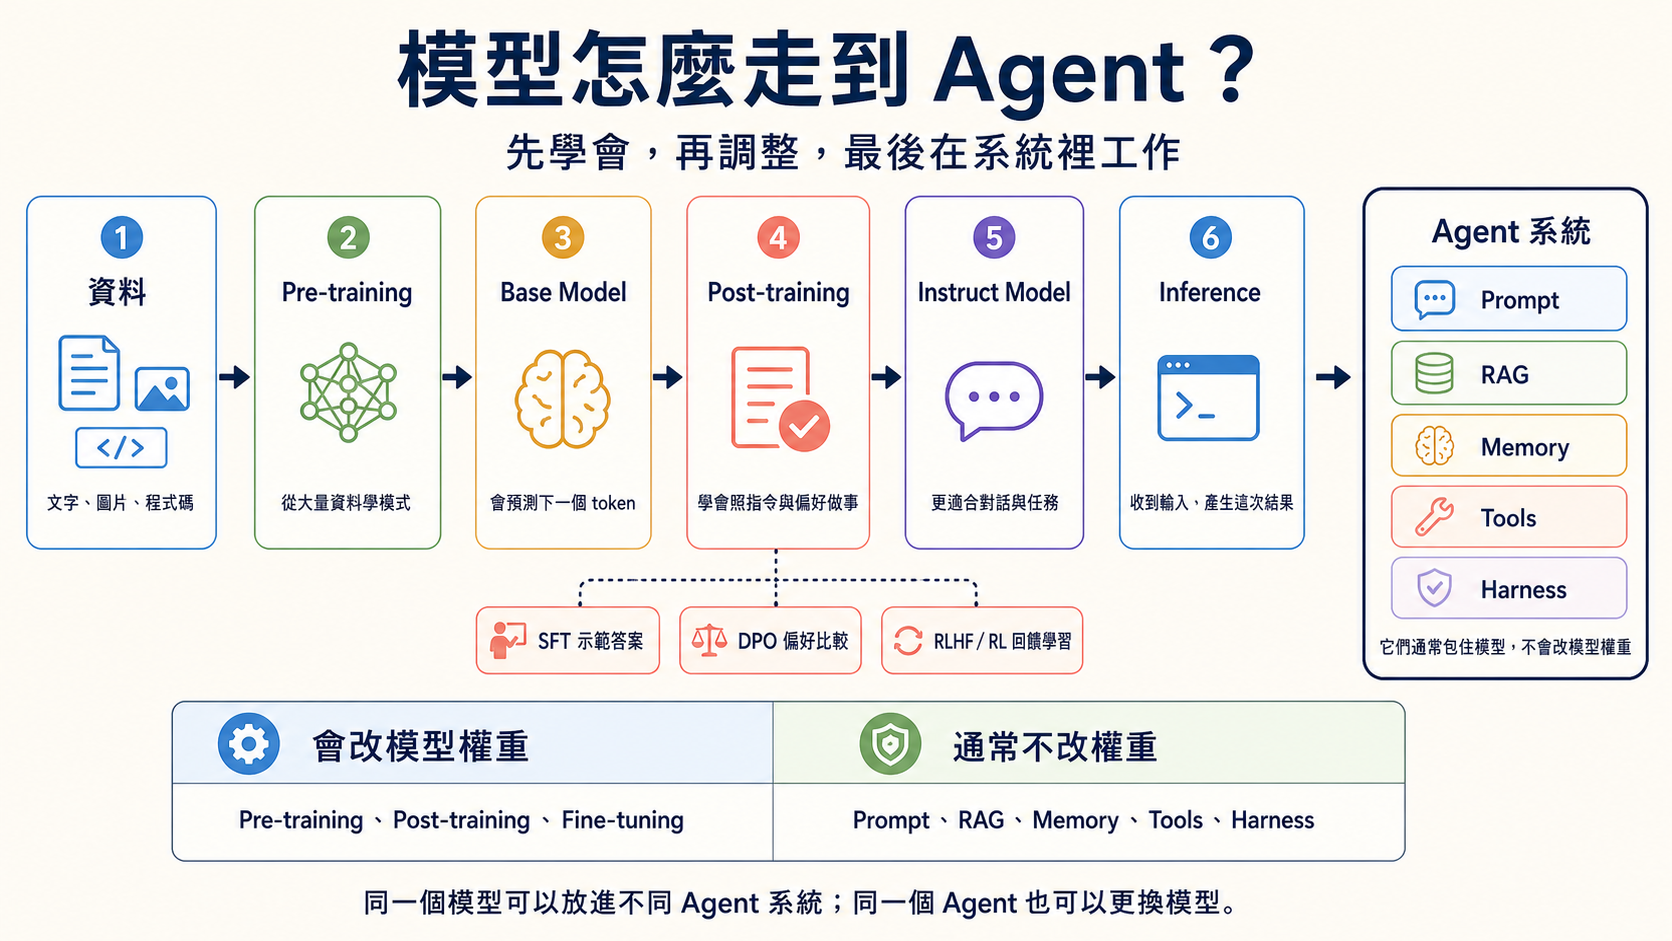
Agent 不是訓練流程的下一個模型版本。它是把模型、Prompt、RAG、Memory、Tools 與 Harness 接在一起的系統。這些零件通常在模型外面工作,不會改變模型權重。
- GRPO(Group Relative Policy Optimization):比較同一題的多個答案,再依相對表現學習。
- LoRA(Low-Rank Adaptation):凍結原本權重,再訓練新增的低秩矩陣。
- PEFT(Parameter-Efficient Fine-Tuning):只訓練較少參數的一組方法。
想知道這些方法與 Distillation、Quantization 的差別,請打開模型訓練與調整選修指南。初學本章不用自己訓練模型。
場景式模型選擇器
先看任務的限制,再看模型;不必先背排行榜。
不是每種 AI 模型都會寫文章。Typed Decision Model(型別化決策模型)只從你先定好的答案中選擇、評分或回傳機率。TypeSafe AI 的 Jev 就是這一類;它不能代替聊天、摘要或寫程式的 LLM。
| 你的場景 | 先試哪條路 | 選擇理由 |
|---|---|---|
| 第一次學 API、想零費用反覆試 | Ollama + gemma4:e4b |
本機執行,單次 API 成本為 $0;同一組範例可反覆改寫。 |
| 要比較雲端品質、資料可送出 | Claude Haiku 4.5/Sonnet 5.5 | Anthropic SDK(Software Development Kit,開發工具與函式庫的工具包) 路徑簡單;按輸入與輸出 token 計費。 |
| OpenAI Agent API | GPT-6.1 Sol/GPT-6 Luna | 難題先試 Sol;大量簡單任務先試 Luna。用自己的任務測,再查價格。 |
| 文件很長,且要處理圖像或影音 | Gemini 3.8 Flash 或 Kimi K3 | 先查型號的 context 與多模態支援,再用自己的文件小測試。 |
| 中文 API 任務,希望控制用量 | DeepSeek V4.1 Flash 或 GLM-5.3 | 先比較官方價格、輸出限制與服務可用性;不要只看模型名稱。 |
| 固定選項的分類、評分或分流,結果要直接交給程式 | Jev 1.13(服務 Early access) | 回傳 Choice、Score 或 Noul 的機率結果;低信心或高風險動作仍要交給人或另一個模型。 |
| 隱私、離線或需自行部署 | Llama 4、Qwen 3.8、Gemma 4 等開放權重 | 先估算硬體與授權,再以 Ollama 或其他推論工具測量實際速度。 |
🚪 進入條件
主要路徑使用本機 Ollama;開始前只要確認時間、工具與預算。
🧭 展開時間、先備、環境與預算
時間與先備
預留約 1 週、5–8 小時。你應能執行 Python script,並對 HTTP/REST 有概念;沒有 API key 也不會卡住,因為本章的主要練習使用本機 Ollama。若還不熟 Python 或命令列,先回 Stage 0。
環境
Path A 需要 Ollama、pip install openai,以及 ollama pull gemma4:e4b。低記憶體可改用 gemma4:e2b。Stage 3 以後的工具呼叫練習才使用 qwen2.5:3b;不要把那些 tag 混到本章的聊天範例。Path B 需要 pip install anthropic 與 ANTHROPIC_API_KEY。
預算
本階段的本機路徑為 $0/次(仍會消耗電力與時間)。若每個練習以 3–5 次作為學習量,雲端總額會隨提示長度與型號變化;先以每次 usage 計算,再把預估次數乘上去。每個練習下方都列出單次與本階段估算,這些是教學估算,不是帳單承諾。
📚 必修閱讀
先知道這七個官方入口;不必讀完才開始練習。
依序閱讀 1–3 後開始練習;4–7 在需要理解模型型號、token 或本機部署時查閱:
- OpenAI:模型如何開發 — 先看資料、訓練與模型之間的關係。
- Google Machine Learning:LLM 調整 — 分清 Prompt Engineering、Fine-tuning 與 Distillation。
- Anthropic Claude 模型總覽 — 型號、context 與價格入口。
- OpenAI API 模型文件 — 型號與計價欄位。
- Google Gemini 模型文件 — GA/Preview 狀態與 context。
- Hugging Face LLM Course:Tokenizers — tokenizer 如何切分文字。
- Ollama 官方網站 — 本機模型安裝與服務啟動。
🛠 動手練習
練習 1:LLM API(hello world)
成果:用五行左右的核心呼叫取得一段回應,並從 usage 讀出輸出 token。單次預算:Ollama $0;Anthropic Haiku 請依回應的 input/output usage 與官方 $1/$5 費率計算。階段預算:本機反覆跑仍為 $0;雲端依 3–5 次與實際 usage 累計。
📋 起手碼 — Path A(本機 Ollama gemma4:e4b、預設)(複製到 practice_1.py、執行 python practice_1.py)
# 需要:pip install openai      (用 OpenAI-compatible SDK 跟 Ollama 溝通)
# 前置:ollama pull gemma4:e4b && ollama serve
import sys
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # Ollama 不檢查、隨便填
)

r = client.chat.completions.create(
    model="gemma4:e4b",   # 換成 qwen2.5:3b / llama3.2:3b 也可
    max_tokens=100,
    messages=[{"role": "user", "content": "用一句話自我介紹。"}],
)

# === 自我驗證 ===
text = r.choices[0].message.content
print("回應:", text)
print("usage:", r.usage)

assert r.choices[0].finish_reason in ("stop", "length"), f"非預期 finish_reason: {r.choices[0].finish_reason}"
assert len(text) > 0, "回應不應為空"
assert r.usage.completion_tokens > 0, "output token 應 > 0"
print("✅ 練習 1 通過 — Ollama gemma4:e4b 已能本機回應、$0/次")
📋 起手碼 — Path B(Anthropic API、選擇性)(複製到 practice_1_anthropic.py)
# 需要:pip install anthropic
# 環境變數:export ANTHROPIC_API_KEY=sk-ant-...
import sys
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

import anthropic

client = anthropic.Anthropic()
msg = client.messages.create(
    model="claude-haiku-4-5",  # haiku 最便宜;換 sonnet 改這行
    max_tokens=100,
    messages=[{"role": "user", "content": "用一句話自我介紹。"}],
)

# === 自我驗證 ===
text = msg.content[0].text
print("回應:", text)
print("usage:", msg.usage)

assert msg.stop_reason in ("end_turn", "max_tokens"), f"非預期 stop_reason: {msg.stop_reason}"
assert len(text) > 0, "回應不應為空"
assert msg.usage.input_tokens > 0 and msg.usage.output_tokens > 0, "token 數應 > 0"
print("✅ 練習 1 通過 — 你已成功打通 Anthropic API")
練習 2:Tokens
成果:以同一個提示重複呼叫,觀察語言、temperature 與輸出長度如何改變 token 使用量。單次預算:Ollama $0;Anthropic Haiku 請依該次 input/output usage 與官方費率計算。階段預算:本機為 $0;Path B 以 3–5 組重複測試的實際 usage 加總。
📋 起手碼 — Path A(本機 Ollama gemma4:e4b、預設)(複製到 practice_2.py)
# 需要:pip install openai     (OpenAI-compatible SDK 跟 Ollama 溝通)
# 前置:ollama pull gemma4:e4b && ollama serve
import sys, statistics
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")

PROMPTS = {
    "中文": "用一句話描述一隻貓在做什麼。",
    "English": "Describe in one sentence what a cat is doing.",
}

N = 10  # 本機慢、N 小一點;確認 OK 後加大
for label, prompt in PROMPTS.items():
    output_tokens = []
    for _ in range(N):
        r = client.chat.completions.create(
            model="gemma4:e4b",
            max_tokens=80,
            temperature=1.0,  # 拉高 temperature 看 variance
            messages=[{"role": "user", "content": prompt}],
        )
        output_tokens.append(r.usage.completion_tokens)
    print(f"\n[{label}] prompt: {prompt}")
    print(f"  input tokens: {r.usage.prompt_tokens}")
    print(f"  output tokens — min={min(output_tokens)} max={max(output_tokens)} mean={statistics.mean(output_tokens):.1f} stdev={statistics.stdev(output_tokens):.1f}")

# === 自我驗證 ===
assert len(output_tokens) == N and all(n > 0 for n in output_tokens), "應觀察到非空的 output token 數"
print("\n✅ 練習 2 通過 — 已觀察到兩種語言的 output token、本機跑 $0")
print("💡 token 數會受 tokenizer 與實際內容影響;不要只用字數推算,也不要預設某種語言一定較多。")
📋 起手碼 — Path B(Anthropic API、選擇性)(複製到 practice_2_anthropic.py)
# 需要:pip install anthropic
import sys, statistics
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

import anthropic

client = anthropic.Anthropic()
PROMPTS = {"中文": "用一句話描述一隻貓在做什麼。", "English": "Describe in one sentence what a cat is doing."}

for label, prompt in PROMPTS.items():
    output_tokens = []
    for _ in range(20):
        msg = client.messages.create(model="claude-haiku-4-5", max_tokens=80, temperature=1.0,
                                     messages=[{"role": "user", "content": prompt}])
        output_tokens.append(msg.usage.output_tokens)
    print(f"[{label}] input={msg.usage.input_tokens} output min/max/mean={min(output_tokens)}/{max(output_tokens)}/{sum(output_tokens)/len(output_tokens):.1f}")
主要差異:client.messages.create()、usage.input_tokens 與 Anthropic content block 的回應形狀,和 Ollama 的 OpenAI-compatible 欄位不同。單次成本請用回應的 token 數計算。
練習 3:Pricing / Latency
成果:把同一個小任務的 token 成本與等待時間分開量測。單次預算:Ollama $0;Anthropic Haiku 依本次 input/output usage 與官方費率計算。階段預算:本機為 $0;若用 Path B,先跑 1 次取得實際輸入/輸出 token,再乘以預計次數,避免直接套用平均值。
📋 起手碼 — Path A(本機 Ollama gemma4:e4b、量 latency)(複製到 practice_3.py)
# 需要:pip install openai
# 前置:ollama pull gemma4:e4b && ollama serve
import sys, time
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")

# 量 5 次 latency 與 output token
latencies = []
output_tokens = []
for _ in range(5):
    t0 = time.time()
    r = client.chat.completions.create(
        model="gemma4:e4b",
        max_tokens=200,
        messages=[{"role": "user", "content": "你好!自我介紹一下。"}],
    )
    latencies.append(time.time() - t0)
    output_tokens.append(r.usage.completion_tokens)

# 統計
avg_latency = sum(latencies) / len(latencies)
out_tok_avg = sum(output_tokens) / len(output_tokens)  # 五次平均
tps = out_tok_avg / avg_latency if avg_latency > 0 else 0

print(f"model: gemma4:e4b (本機)")
print(f"5 次 latency (sec): min={min(latencies):.2f} max={max(latencies):.2f} mean={avg_latency:.2f}")
print(f"avg output: {out_tok_avg} tokens、約 {tps:.1f} tokens/sec")
print(f"\n1000 次成本: $0 (本機)、預計時長: {avg_latency * 1000 / 60:.1f} 分鐘")

# === 自我驗證 ===
assert avg_latency > 0, "latency 應 > 0"
assert out_tok_avg > 0, "output token 應 > 0"
print(f"\n✅ 練習 3 通過 — 本機 model $0 但要花 {avg_latency * 1000 / 60:.0f} 分鐘跑 1000 次")
print("💡 對照 Path B Anthropic:請以實際 input/output usage 與官方費率估算 1000 次成本,再和本機等待時間比較。")
📋 起手碼 — Path B(Anthropic API、算 $ 成本)(複製到 practice_3_anthropic.py)
# 需要:pip install anthropic
import sys
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

import anthropic

# Anthropic 公開計價(每 1M token、USD)— 跑前對照 https://www.anthropic.com/pricing
PRICING = {
    "claude-haiku-4-5":   {"input": 1.00, "output":  5.00},
    "claude-sonnet-5-5":  {"input": 2.00, "output": 10.00},
    "claude-opus-5-5":    {"input": 4.00, "output": 20.00},
    "claude-fable-5-1":   {"input": 10.00, "output": 50.00},
}

client = anthropic.Anthropic()
MODEL = "claude-haiku-4-5"

msg = client.messages.create(model=MODEL, max_tokens=200,
                             messages=[{"role": "user", "content": "你好!自我介紹一下。"}])
in_tok, out_tok = msg.usage.input_tokens, msg.usage.output_tokens
rates = PRICING[MODEL]
cost_one = (in_tok * rates["input"] + out_tok * rates["output"]) / 1_000_000

print(f"model: {MODEL}")
print(f"single: input={in_tok} output={out_tok} → ${cost_one:.6f}")
print(f"1000 calls cost across model tiers:")
for name, r in PRICING.items():
    c = (in_tok * r["input"] + out_tok * r["output"]) / 1_000_000 * 1000
    print(f"  {name:<22} ${c:.4f}")

# === 自我驗證 ===
assert cost_one > 0, "Cloud LLM 一定有成本"
print(f"\n✅ 練習 3 通過(Anthropic)— 1000 次 haiku、sonnet、opus 與 fable 的成本已按實際 token 算出")
🎯 精選 Projects
推薦 Capstone:個人文件摘要成本/品質比較器
建立一個小型命令列工具:讀入 3–5 段你有權使用的文字,分別用 Ollama 與一個 Anthropic 型號摘要;記錄輸入/輸出 token、延遲、估算成本,並用固定檢查表標註摘要是否遺漏關鍵事實。它把本章三個核心詞和模型選擇器連在一起,不要求先做 RAG 或 agent。
📦 Capstone 的驗收清單與其他 Project 入口
完成後應能展示:
- 同一份輸入的兩條路徑與模型名稱。
- 每次呼叫的 input/output token、延遲與單次成本。
- 一個固定的品質檢查表,而不是只憑主觀印象選模型。
- 一段說明:何時用本機、何時接受雲端成本,以及 context 不足時怎麼分批。
以下表格保留本章原有的 17 個延伸入口;它們是選讀資源,不是本章必做項目。推薦度是編輯判斷,不是 GitHub 熱門度:⭐⭐⭐⭐⭐ 代表跳過會卡住;本表都是補充入口,所以誠實使用 ⭐⭐⭐⭐、⭐⭐⭐ 或歷史參考的 ⭐⭐,不列會變動的 stars。
| 分類 | 資源 | 入口 | 推薦度 | 用途/狀態 |
|---|---|---|---|---|
| 官方 API 入門 | Anthropic Cookbook | GitHub | ⭐⭐⭐⭐ | Claude API notebook;可查 tool use、batch 與 prompt cache。 |
| Anthropic Courses | GitHub | ⭐⭐⭐⭐ | 已封存的官方課程;可看舊範例,動手時請對照下方現行 API Quickstart。 | |
| OpenAI Cookbook | GitHub | ⭐⭐⭐⭐ | OpenAI API、structured output 與 function calling 範例。 | |
| Anthropic Claude API Quickstart | 官方文件 | ⭐⭐⭐ | 快速完成第一個 Claude API 呼叫。 | |
| 中文教材 | datawhalechina/happy-llm | GitHub | ⭐⭐⭐⭐ | 以中文理解 LLM 原理與訓練流程。 |
| datawhalechina/llm-universe | GitHub | ⭐⭐⭐⭐ | 從 API 基礎延伸到知識庫與 RAG。 | |
| datawhalechina/llm-cookbook | GitHub | ⭐⭐⭐ | Andrew Ng 課程的中文改編;更新速度較慢。 | |
| jingyaogong/minimind | GitHub | ⭐⭐⭐ | 從零實作小型模型訓練;Apache-2.0。 | |
| 英文課程 | Hugging Face — LLM Course | 課程 | ⭐⭐⭐⭐ | Transformer、tokenizer 與 Hugging Face 生態。 |
| LangChain Academy | 課程 | ⭐⭐⭐ | 官方免費課程;包含 RAG 與 agent。 | |
| 本機執行 | ollama/ollama | GitHub | ⭐⭐⭐⭐ | 本章 Path A 的本機執行入口。 |
| ggml-org/llama.cpp | GitHub | ⭐⭐⭐⭐ | 理解量化與本機推論底層。 | |
| mudler/LocalAI | GitHub | ⭐⭐⭐ | 提供 OpenAI 相容的 self-host 服務。 | |
| ml-explore/mlx | GitHub | ⭐⭐⭐ | Apple Silicon 的機器學習框架。 | |
| 從零理解 | Karpathy — Let's build GPT from scratch | 影片 | ⭐⭐⭐⭐ | 以 PyTorch 示範從零建立 GPT。 |
| rasbt/LLMs-from-scratch | GitHub | ⭐⭐⭐⭐ | 以書本與程式碼深入 tokenizer、attention 與訓練。 | |
| karpathy/LLM101n | GitHub | ⭐⭐ | 已封存的課程大綱;屬歷史參考,不是現行教學。 |
其他 Project(按難度)
- 入門:多語言 token 計數器、單句摘要器、temperature 對照表。
- 中階:跨供應商 prompt 評測器、錯誤重試包裝器、本機模型延遲儀表板。
- 延伸:小型文件分批摘要流程、可配置的模型路由器、隱私資料的本機推論服務。
練習 4:Cross-Provider 比較
成果:用同一提示比較不同供應商的輸出,並記錄差異而不把單次結果當成排名。單次預算:Path A Ollama $0;Path B 依三家 API 的實際 token 計費。階段預算:本機為 $0;雲端先各跑 1 次,再按 3–5 組評測估算。
🔬 練習 4 詳細路徑(選做)
- Path A(Ollama,主要練習):使用
examples/stage-1/04-cross-provider/的 Ollama 呼叫,先讓本機結果成為基準。 - Path B(Anthropic,選擇性):在同一資料集上加入 Anthropic SDK;若也加入 OpenAI/Google,請逐一記錄型號、參數、token 與失敗情況。
- 比較回答風格、長度、格式遵守度與事實遺漏;把結果視為你的任務小評測,不是官方規格或普遍排名。
這個 starter 含三家 SDK 並行呼叫與 table 對照,缺哪家 key 就 skip 哪家;它是 illustrative 範例,不是 chapter-length 教學。
練習 5:Error Handling
成果:為錯誤分類、重試與停止條件寫出可測試的處理流程。單次預算:Path A Ollama $0;Path B 若只用 mock 不產生 API 費用。階段預算:本機與 mock 測試為 $0;若加入雲端整合測試,限制為 1–2 次並按實際 token 加總。
🧰 練習 5 詳細路徑(選做)
- Path A(Ollama,主要練習):先在
examples/stage-1/05-error-handling/執行 mock-based test,再用本機端點觀察可恢復的網路錯誤。 - Path B(Anthropic,選擇性):以 Anthropic SDK 的例外型別接上相同的 retry wrapper;API key 錯誤與 context 過長不應無限重試。
- 至少覆蓋錯誤 API key、提示過長與網路中斷;exponential backoff 要有上限與明確的最大嘗試次數。
這個 starter 讓你不用真的斷網就能驗證重試邏輯;它是 illustrative 範例,不是 chapter-length 教學。
練習 6:Local LLM
成果:在自己的電腦上啟動 Ollama,並以 OpenAI-compatible API 呼叫本機模型。單次預算:Ollama $0(另有硬體電力成本);Path B 雲端依實際 token 計費。階段預算:本機練習為 $0;若用 Anthropic 做一次品質對照,先限制為 1–3 次並記錄 usage。
🦙 練習 6 詳細路徑(選做)
Path A(Ollama,主要可執行路徑):
# 1. 裝 Ollama: https://ollama.com
ollama pull qwen2.5:3b
ollama serve  # 預設 port 11434
# 需要:pip install openai
# 前置:Ollama 已 serve、qwen2.5:3b 已 pull
import sys
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")

from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # Ollama 不檢查、隨便填
)

r = client.chat.completions.create(
    model="qwen2.5:3b",
    messages=[{"role": "user", "content": "用 3 句話介紹什麼是 ReAct。"}],
)

text = r.choices[0].message.content
print("回應:", text)

# === 自我驗證 ===
assert len(text) > 10, "回應太短、Ollama 可能沒跑起來"
print(f"✅ 練習 6 通過 — 你的本機 Ollama 已能透過 OpenAI-compatible API 呼叫")
print(f"💡 跑這次完全沒花錢(除了你的電力)")
Path B(Anthropic,選擇性):把同一個 ReAct 提示送到 claude-haiku-4-5,保存回應與 msg.usage,再和 Path A 的格式遵守度、延遲及成本比較。不要把雲端結果當成本機模型的規格保證。
若沒有 Ollama,可把 base_url 換成 LM Studio(http://localhost:1234/v1)或 vLLM endpoint;介面相同,但模型 tag 與硬體需求要重新確認。
🌐 完整 18 家族資料表(官方規格入口)
全表查核:2026-09-22 UTC。GPT 一列更新:2026-10-02 UTC。Claude 一列更新:2026-09-28 UTC。Gemini 一列更新:2026-10-02 UTC。
沒有可靠公開數字就寫「官方未公布」。價格通常是 USD/每 1M token;供應商若用別的單位,就照官方單位記錄。 快取(cache)像重用已讀過的便條:讀取舊內容與寫入新內容可能有不同價格。
| 家族 | 目前推薦型號 | 狀態 | Context | 價格或授權 | 適合做什麼 | 限制 | 官方來源 |
|---|---|---|---|---|---|---|---|
| Claude | Fable 5.1(claude-fable-5-1);Mythos 5.1(claude-mythos-5-1);Opus 5.5(claude-opus-5-5);Sonnet 5.5(claude-sonnet-5-5);Haiku 4.5 |
Fable/Opus/Sonnet/Haiku:正式可用;Mythos:限核准使用者 | 多數為 1M context/128K 最大輸出;Haiku 為 200K/64K | Claude API:Fable/Mythos US$10/$50、Opus US$4/$20、Sonnet US$2/$10、Haiku US$1/$5(每百萬輸入/輸出 token);Sonnet/Opus cache read US$0.20,Fable/Mythos US$0.25 | 長文、程式、長時間 Agent 工作流 | Mythos 5.1 限資安與生命科學核准使用者;Sonnet 5.5 的工具指定與 temperature 設定不同於舊版,升級既有程式前先看遷移指南;雲端夥伴平台價格另查 | Claude 模型總覽 · Opus 5.5 · Sonnet 5.5 · 遷移指南 · Claude API 價格 |
| GPT | GPT-6 Astra(gpt-6-astra);GPT-6.1 Sol(gpt-6.1-sol);GPT-6 Luna(gpt-6-luna) |
正式 API 模型;免費層不支援 | 1.05M context/128K 最大輸出 | Standard API,每百萬 token,US$ 輸入/cache 讀/cache 寫/輸出。Astra $10/$1/$12.50/$50。Sol 6.1 $2/$0.10/$2.50/$10。Luna $0.10/$0.01/$0.125/$0.50 | Sol 6.1 用於程式與多步 Agent 工作;Luna 用於聚焦、重複任務;Astra 的成本與品質差異要自行評測 | Sol 6.1 的工具呼叫須用 Responses API;Chat Completions 不支援工具呼叫。超過 272K 輸入時,整次請求輸入與 cache 價為 2 倍、輸出為 1.5 倍。Batch/Flex 半價,Fast 為 2 倍。工具可能另計費 | GPT-6 Astra · GPT-6.1 Sol · GPT-6 Luna · OpenAI API 價格 |
| Jev(TypeSafe AI) | TypeSafe direct:Jev 1.13(jev-1.13.0),穩定 alias jev-latest;Cloudflare route:typesafe/jev |
正式模型;服務仍為 Early access | TypeSafe direct:64K/request,state 加最長 question 上限 32K;Cloudflare route:32K |
TypeSafe direct:$0.042/百萬 input token,output 不計費;Cloudflare route:以 Cloudflare dashboard 顯示為準 | 固定選項分類、路由、rubric 評分與 guardrail 判斷 | 不產生自由文字;機率不等於正確,門檻、權限與 fallback 要由自己的程式與 Eval 決定 | TypeSafe 模型規格 · Jev 入門 · Early access 公告 · Cloudflare route |
| Gemini | Gemini 3.8 Flash;Gemini 4 Argon(發布參考;限制開放) | Flash:正式可用;Argon:限 Fairwind 可信資安防禦者 | Flash:1,048,576 context/65,536 最大輸出。Argon:公告 1M 輸出上限,公開 API context 規格未公布 | Flash:2026-12-31 前介紹價 $0.75/$3.75(輸入/輸出)。Argon:公告未來介紹價 $2/$10,期滿後 $4/$20;每百萬 token | Flash 用於可實作的多模態與 Agent 練習;Argon 是長任務模型的官方發布參考 | Argon 的一般 API/Google AI Ultra 開放仍待後續發布,公開 API model ID 未公布。不能拿來當本章可執行預設 | Gemini 3.8 Flash · Gemini API 定價 · Gemini 4 Argon 公告 |
| DeepSeek | V4.1 Flash(deepseek-flash);V4 Pro(deepseek-v4-pro) |
兩者 API 仍可用;舊 V4 Flash 已退役 | 1M context/384K 最大輸出 | 每百萬 token,尖峰/離峰:Flash 輸入 US$0.30/$0.15、輸出 US$1.20/$0.60、cache hit US$0.006/$0.003;Pro 輸入 US$1.32/$0.66、輸出 US$3.96/$1.98、cache hit US$0.044/$0.022 | 推理、程式與大量 token 任務 | deepseek-v4-flash 舊名暫時導向 V4.1 Flash,不代表舊模型仍在;Pro 原定下線後官方決定繼續提供。尖峰為週一至週五 UTC 01–04、06–10 時 |
DeepSeek 模型與價格 · 更新紀錄 |
| Kimi | kimi-k3 |
正式可用 | 1M | API:cache hit/輸入/輸出各 CNY 2/20/100,每百萬 tokens | 中文長文、視覺輸入、長上下文任務 | 2.8T 參數;部署與配額依平台 | Kimi 平台總覽 · Kimi API 定價 |
| Hunyuan | Hy3(TokenHub) |
正式可用 | 256K | API:cache hit/輸入/輸出各 CNY 0.25/1/4,每百萬 tokens | 中文推理與 Tencent Cloud 整合 | hy3-preview 已於 2026-08-31 下線;Hy4 仍是 Preview |
TokenHub 模型列表 · TokenHub 定價 · Hy3 遷移公告 |
| MiniMax | MiniMax M3 | 開放權重 | 1M | MiniMax API 官網列的優惠價:context ≤512K 為每百萬輸入/cache read/輸出 token US$0.30/$0.06/$1.20;512K–1M 為 US$0.60/$0.12/$2.40;權重採 MiniMax Community License | 文字、視覺、coding 與自架工作 | 優惠與轉售平台價格可能變動;不是 Apache/MIT,使用或散布權重要先讀授權 | MiniMax M3 model card · MiniMax API 定價 |
| Qwen | qwen3.8-max(API);Qwen3.8 開放權重變體 | 正式可用 | 1M | API 依區域定價;例如北京為 CNY 12/36,每百萬輸入/輸出 tokens;開放權重變體依各自授權 | 中文任務、多模態、可自架工作流 | API 型號與開放權重變體不可混用;各自的可用性與授權要分開確認 | Qwen 3.8 Max |
| GLM | GLM-5.3 | 正式可用 | 1M(輸出 128K) | API:輸入/cache hit/輸出各 US$1.40/$0.26/$4.40,每百萬 tokens | 中文 agent、工具使用、推理 | 純文字;reasoning 一律啟用 | GLM-5.3 文件 · GLM API 定價 |
| Yi | Yi-34B/Yi-9B 及 200K 變體 | 凍結/歷史 | 200K(部分舊型號) | 官方 repo 授權;現行 API 價格官方未公布 | 重現既有 Yi 實驗、自架歷史基線 | 官方 repo 未證明目前仍有維護或現行 frontier 後繼型號;新專案先選現行型號 | 01.AI Yi repository |
| Llama | Llama 4 Scout/Maverick;Llama 3.3 70B(較實用舊基線) | 開放權重 | Scout 10M | Llama Community License | 自架、微調、生態整合 | Scout 需要 H100 等級硬體;授權不是 Apache/MIT | Meta Llama 文件 |
| Muse | Muse Spark 1.3(Standard:muse-spark-1.3;Contributor:muse-spark-1.3-contributor);Muse Glimmer 30B |
Spark:Meta Model API 公開預覽;Glimmer:開放權重 | Spark 約 1M;Glimmer 131K | Spark Standard:每百萬 token 輸入/cache hit/輸出 US$1.25/$0.15/$4.25;Contributor:US$0.10/$0.002/$0.20,但允許 Meta 使用輸入與輸出訓練模型。Glimmer:Apache 2.0 | Spark 做雲端 Agent 與程式任務;Glimmer 做本機 Agent | 個人 Agent 產品 Muse、API 模型 Spark、開放權重 Glimmer 是不同東西;Spark 1.3 的音訊理解尚未完整支援 | Meta Model API 模型 · 價格與資料方案 · Muse Glimmer |
| Grok | Grok 4.7(grok-4.7) |
正式可用 | 500K | xAI API:每百萬 token 輸入/cache hit/輸出 US$2/$0.50/$6;提示達 200K 時,整次請求改用 US$4/$1/$12 | 程式、工具呼叫與多步 Agent 任務 | 美國區域端點另加 10%;伺服器工具呼叫可能另計費 | Grok 4.7 規格 · xAI 價格 |
| MiMo | MiMo V2.6 Pro(mimo-v2.6-pro) |
正式可用 API | 1M context/128K 最大輸出 | Xiaomi API:每百萬 token 輸入/cache hit/輸出 US$0.435/$0.0036/$0.87;官方另列 CNY 3/0.025/6 | 長任務、工具呼叫與多模態輸入的 Agent | 要確認帳號可用地區、配額與實際帳單;不要把供應商自述 benchmark 當跨模型排名 | MiMo V2.6 Pro 規格與價格 · MiMo API 模型列表 |
| Gemma | Gemma 4:E2B、E4B、12B、26B A4B、31B | 開放權重 | 小型型號 128K;中型型號 256K | Gemma 4 Terms/license;不是 Apache 2.0 | Edge、本機與受限硬體實驗 | 授權條款須逐項閱讀;硬體需求依型號 | Gemma 核心文件 · Gemma Terms |
| Mistral | Mistral Small 4;Large 3;Ministral 3 | 正式可用 | Small 4:256K | Small 4 $0.15/$0.60;Apache 2.0 開放權重依版本 | reasoning、vision、coding 與自架 | 不同型號的 API 與授權不同 | Mistral Small 4 |
| Phi | Phi-4 14B;Phi-4 mini/multimodal | 開放權重 | Phi-4 multimodal 128K | Phi-4 multimodal MIT;依型號查授權 | 小型推理、多模態、edge | 不宣稱固定 RAM;量化方法會改變硬體需求 | Microsoft Phi · Phi-4 multimodal |
想做「聽人說話、立刻用聲音回答」的 Agent,可選讀 Gemini 3.8 Live。它是獨立的穩定語音 API 型號,不等於上表的 Gemini 3.8 Flash;費用與功能要看 Gemini API 價格頁。
🧪 補充解釋、排錯與個人評測工具
為什麼 temperature 會改變輸出
LLM 每一步都會預測下一個 token 的機率分布,再依設定選出候選。低 temperature 讓分布更集中;高 temperature 讓較少見的候選也有機會被選到。max_tokens 是輸出上限,不是保證輸出長度。這個模型只是理解參數的簡化圖像;實際行為仍依供應商實作。
常見問題
Connection refused:確認ollama serve正在執行,且base_url的 port 是 11434。- 找不到模型:先用
ollama list,再以ollama pull gemma4:e4b安裝;不要自行猜測 tag。 - 回應被截斷:降低提示長度或
max_tokens,並檢查型號的 context window。 - API 失敗:先保存型號、狀態碼與 request id;只有暫時性網路/服務錯誤才重試,認證與 context 錯誤應先修正輸入。
- 成本對不上:把 input 與 output 分開乘單價;快取命中、批次與方案可能改變實際價格。
第三方 benchmark
Artificial Analysis、Arena AI、Vellum leaderboard、Hugging Face Open LLM Leaderboard 與 SuperCLUE 可作為個人任務的評測工具。它們不是供應商的官方規格,也不能取代你的資料、提示與延遲測試。
自我檢查
前往 Stage 2 前,確認你能:
- 說明 API、token 與 context window 各自解決什麼問題。
- 跑通練習 1 的 Ollama Path A,並從
usage讀到輸出 token。 - 用一次實測的 input/output token 算出一個雲端呼叫成本。
- 為一個場景說明選本機或雲端的理由,並列出一項限制。
若可以,進入 Stage 2 — Prompt Engineering。若還不行,先重跑練習 1–3 的 Path A,再按需打開閱讀或排錯區塊。
✅ Stage 1 完成? 接下來 Stage 2 — Prompt Engineering 會帶你寫出可重用的結構化 prompt,並用 eval 量化改善幅度。